

پاسخ سریع: مانیتورینگ سرویس یعنی وضعیت قابل اندازهگیری سایت، برنامه و زیرساخت را بهطور پیوسته بررسی کنید و برای شرایط مهم هشدار بگیرید. برای یک تیم کوچک، شروع عملی این است: Uptime Kuma برای دسترسپذیری، Grafana برای متریکها و داشبورد، و ELK Stack برای جمعآوری و جستوجوی لاگها. لازم نیست از روز اول همهچیز را اندازه بگیرید؛ ابتدا چند نشانه نزدیک به تجربه کاربر و چند منبع اصلی خطا را پوشش دهید.
پایداری فقط «روشن بودن سرور» نیست. ممکن است صفحه باز شود اما ورود کاربر خطا بدهد، درخواستها کند باشند، فضای دیسک رو به پایان باشد یا پرداخت در میانه مسیر متوقف شود. مانیتورینگ خوب باید زود هشدار دهد؛ Observability یا مشاهدهپذیری کمک میکند بفهمید چرا این اتفاق افتاده است.
تفاوت Monitoring و Observability چیست؟
Monitoring معمولاً با سؤالهای از قبل شناختهشده شروع میشود: آیا سایت بالا است؟ CPU چقدر مصرف میشود؟ نرخ خطا از حد مجاز بیشتر شده؟ Observability دید وسیعتری میدهد تا با استفاده از شواهد بیرونی سیستم، علت مسئلههای تازه و پیشبینینشده را بررسی کنید. مستندات OpenTelemetry سه سیگنال اصلی Telemetry را Log، Metric و Trace معرفی میکند.
- Metric: عددی که در طول زمان اندازهگیری میشود؛ مانند مصرف CPU، زمان پاسخ یا تعداد خطا.
- Log: پیام زماندار درباره یک رویداد؛ مانند خطای اتصال به دیتابیس.
- Trace: مسیر یک درخواست در اجزای مختلف؛ برای نمونه از API تا سرویس پرداخت و دیتابیس.
برای یک سرویس ساده ممکن است Uptime، چند Metric و Log ساختیافته کافی باشد. Trace زمانی ارزش بیشتری پیدا میکند که درخواست از چند سرویس عبور میکند و پیدا کردن محل کندی یا خطا دشوار شده است.
برای تیم کوچک چه چیزهایی را مانیتور کنیم؟
با چهار سؤال ساده شروع کنید:
- آیا کاربر به سرویس میرسد؟ وضعیت HTTP، DNS، گواهی TLS و زمان پاسخ.
- آیا سرویس درست کار میکند؟ نرخ خطا، ورود موفق، ثبت سفارش یا یک Health Check واقعی.
- آیا منابع در حال تمامشدناند؟ CPU، RAM، Disk، تعداد اتصال و حجم داده.
- اگر خطا رخ داد چه مدرکی داریم؟ Logهای قابل جستوجو با زمان، سطح، نام سرویس و شناسه درخواست.
این فهرست کوچک از دهها نمودار بدون مالک مفیدتر است. هر شاخص باید یک دلیل، یک محدوده عادی و یک مسئول پاسخگو داشته باشد.
لایه اول: بررسی دسترسپذیری با Uptime Kuma
Uptime Kuma از بیرون سرویس را بررسی میکند و میتواند برای مانیتورهای مختلف وضعیت، زمان پاسخ و گواهی را دنبال کند. اگر چند بار پیاپی پاسخ مناسب دریافت نشود، هشدار ارسال میشود. همچنین میتوانید Status Page بسازید تا وضعیت سرویسهای انتخابشده را به کاربران یا تیم داخلی نشان دهید.
فقط صفحه اصلی را مانیتور نکنید. یک Endpoint سبک مثل /health بسازید که وابستگیهای ضروری را بررسی کند؛ اما اطلاعات حساس یا جزئیات خطا را عمومی نمایش ندهد. فاصله بررسی و تعداد Retry را طوری تنظیم کنید که نوسان لحظهای باعث هشدار بیفایده نشود. راهنمای راهاندازی Uptime Kuma و ساخت Status Page در آرانیک این مراحل را عملی توضیح میدهد.
لایه دوم: متریک و داشبورد با Grafana
Grafana خودش الزاماً محل تولید داده نیست؛ به Data Source متصل میشود، داده را Query میکند و در Panel و Dashboard نمایش میدهد. طبق مستندات رسمی Grafana، منبع داده میتواند سامانه متریک، Log، Trace، دیتابیس SQL یا API باشد. پس پیش از ساخت نمودار باید مشخص کنید داده کجا تولید و نگهداری میشود.
داشبورد شروع تیم کوچک میتواند پنج Panel داشته باشد: دسترسپذیری، زمان پاسخ، نرخ خطا، CPU/RAM و Disk. اگر دیتابیس گلوگاه است، تعداد اتصال و Queryهای کند را اضافه کنید. داشبوردها را براساس مخاطب جدا کنید؛ مدیر محصول به رفتار کاربر و خطای مسیرهای اصلی نیاز دارد، اما مسئول فنی جزئیات منابع و سرویسها را میخواهد.
برای ساخت اولین داشبورد و اتصال منبع داده، مقاله آموزش Grafana و داشبوردهای مانیتورینگ در آرانیک را دنبال کنید.
لایه سوم: جمعآوری و جستوجوی Log با ELK Stack
متریک میگوید خطا زیاد شده، اما معمولاً جزئیات علت در Log پیدا میشود. یک Log خوب فقط متن «خطا رخ داد» نیست. زمان، سطح رویداد، نام سرویس، محیط، شناسه درخواست و پیام قابل فهم باید کنار هم باشند. رمز، Token، داده هویتی و اطلاعات کارت نباید وارد Log شوند.
ELK Stack برای جمعآوری، پردازش، ذخیره، جستوجو و نمایش Logها استفاده میشود. Logstash میتواند داده ورودی را پردازش کند، Elasticsearch آن را ایندکس و قابل جستوجو میکند و Kibana برای بررسی و داشبورد به کار میرود. در نسخههای جدید اکوسیستم Elastic مسیرهای جمعآوری دیگری هم وجود دارد؛ اما اصل معماری ثابت است: Log باید از سرویسها جمع، ساختیافته، نگهداری و قابل جستوجو شود.
راهنمای دیپلوی ELK Stack و پایش زنده لاگها در آرانیک نصب و اولین بررسی Log را پوشش میدهد.
هشدار خوب چه ویژگیهایی دارد؟
هشدار خوب قابل اقدام است. پیام باید بگوید کدام سرویس، از چه زمانی، با چه شدت و بر اساس کدام شرط مشکل دارد. همچنین باید لینک داشبورد یا Runbook و مسئول پیگیری را مشخص کند. هشدار «CPU بالا» بدون دانستن مدت، مقدار و اثر کاربر معمولاً فقط اضطراب تولید میکند.
- برای نوسان کوتاه از شرط زمانی یا چند بار Retry استفاده کنید.
- شدتها را جدا کنید: اطلاع، هشدار و بحرانی.
- هشدارهای تکراری یک رخداد را گروهبندی کنید.
- بعد از رفع مشکل، پیام Recovery بفرستید.
- هر هشدار باید مالک و مسیر Escalation داشته باشد.
SLI و SLO به زبان ساده
SLI یک شاخص واقعی از رفتار سرویس است؛ مانند درصد درخواستهای موفق یا زمان بارگذاری از نگاه کاربر. SLO هدفی است که برای آن شاخص تعیین میکنید؛ برای نمونه، «۹۹٫۹ درصد درخواستهای مسیر ورود در یک ماه موفق باشند». تعریف هدف کمک میکند تیم بداند چه چیزی واقعاً مهم است و کدام هشدار باید اولویت بیشتری داشته باشد.
برای شروع لازم نیست قرارداد پیچیده بنویسید. یک مسیر حیاتی انتخاب کنید، شاخص موفقیت آن را تعریف کنید، مقدار هدف و بازه زمانی بگذارید و هر ماه نتیجه را مرور کنید. Uptime تنها SLI ممکن نیست؛ سرویس ممکن است بالا باشد ولی پاسخ اشتباه یا بسیار کند بدهد.
مسیر رسیدگی به رخداد
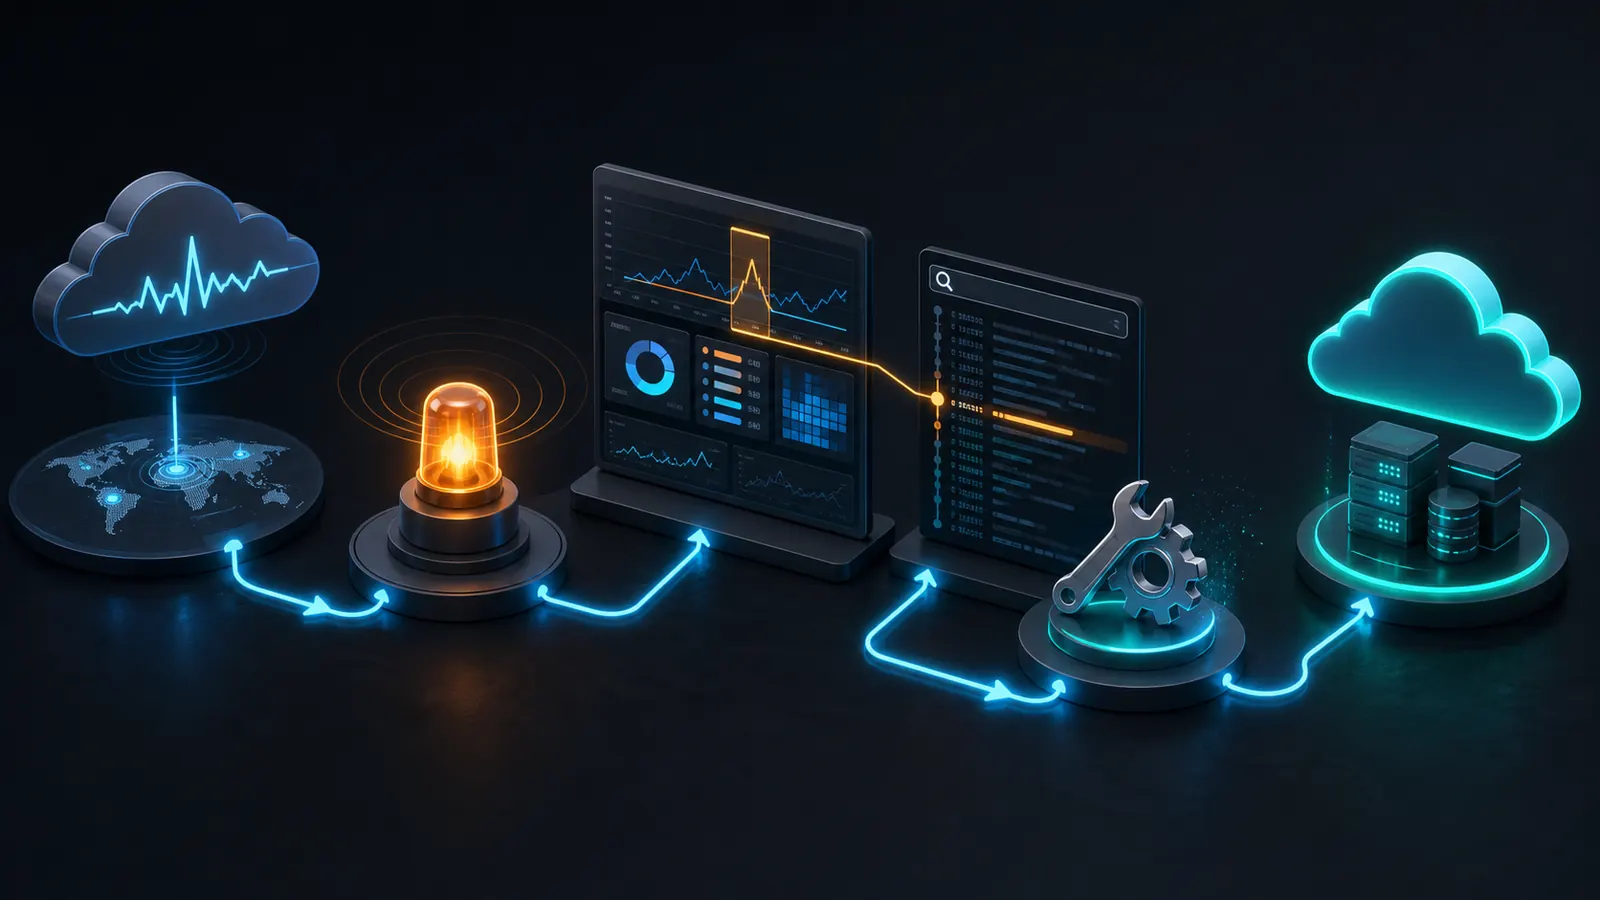
- تشخیص: Uptime Kuma یا قانون هشدار وضعیت غیرعادی را اعلام میکند.
- تأیید اثر: بررسی کنید چند کاربر یا کدام مسیر کسبوکار تحت تأثیر است.
- محدودکردن دامنه: داشبورد Grafana نشان میدهد مشکل از منابع، دیتابیس یا یک سرویس خاص است.
- یافتن علت: Logهای همان بازه و شناسه درخواست را در ELK جستوجو کنید.
- کاهش اثر: Rollback، Restart کنترلشده، افزایش منبع یا غیرفعالکردن قابلیت مشکلدار.
- بررسی پس از رخداد: خط زمانی، علت، اقدام اصلاحی و روش جلوگیری از تکرار را ثبت کنید.
در رخداد واقعی اول سرویس را پایدار کنید و بعد تحلیل عمیق انجام دهید. تغییرهای متعدد و ثبتنشده هنگام بحران، یافتن علت را دشوارتر میکند.
امنیت و نگهداری دادههای مانیتورینگ
Telemetry میتواند اطلاعات حساس داشته باشد. Query URL، Header، پیام خطا و Log برنامه گاهی شامل ایمیل، Token یا داده کاربر است. پیش از ارسال داده به سامانه مانیتورینگ، فیلدهای حساس را حذف یا Mask کنید. دسترسی داشبورد و جستوجوی Log را نقشمحور و حسابهای مدیریتی را با رمز قوی محافظت کنید.
Retention یا مدت نگهداری را هم مشخص کنید. نگهداری بینهایت Log هزینه دیسک و ریسک دسترسی را زیاد میکند. برای هر نوع داده مدت متناسب تعیین کنید؛ مثلاً متریک فشرده میتواند طولانیتر از Log جزئی نگهداری شود. رشد Index و فضای Disk باید خودش مانیتور شود.
برنامه هفتروزه برای تیم تازهکار
- روز اول: سه مسیر حیاتی کاربر را انتخاب کنید.
- روز دوم: برای صفحه اصلی و Health Check مانیتور Uptime بسازید.
- روز سوم: کانال هشدار و مسئول هر سرویس را مشخص کنید.
- روز چهارم: CPU، RAM، Disk، زمان پاسخ و نرخ خطا را به داشبورد اضافه کنید.
- روز پنجم: Logها را ساختیافته و فیلدهای حساس را حذف کنید.
- روز ششم: یک Runbook یکصفحهای برای خطای رایج بنویسید.
- روز هفتم: یک تمرین اختلال کنترلشده اجرا و دریافت هشدار تا بازیابی را ثبت کنید.
راهاندازی ابزارهای مانیتورینگ در آرانیک
Uptime Kuma، Grafana و ELK Stack را براساس نیاز و ظرفیت خود بهصورت سرویسهای جدا بسازید. جدا بودن منابع باعث میشود رشد Log یا داشبورد مستقیماً برنامه اصلی را متوقف نکند. برای ELK از ابتدا فضای Disk و Retention را جدی بگیرید؛ برای Grafana اطلاعات Data Source را با حساب حداقلی وارد کنید؛ و Uptime Kuma را از محیطی قرار دهید که واقعاً بتواند سرویس هدف را بررسی کند.
اگر با ساخت سرویس آماده آشنا نیستید، راهنمای ایزیاینستال آرانیک را ببینید. برای معماری کاملتر اپلیکیشن نیز مقاله زیرساخت لازم برای اپلیکیشن ساختهشده با AI ارتباط کد، اجرا، داده، امنیت و پایش را توضیح میدهد.
اشتباههای رایج مانیتورینگ
- مانیتورکردن فقط CPU و نادیدهگرفتن تجربه واقعی کاربر.
- ساخت دهها هشدار بدون مالک، شدت و Runbook.
- ارسال Token، رمز یا داده شخصی داخل Log.
- قرار دادن سامانه مانیتورینگ روی همان نقطه خطای سرویس اصلی.
- نگهداری نامحدود Log و پرشدن Disk.
- ساخت داشبورد زیبا بدون تصمیم یا اقدام مشخص.
- نداشتن پیام Recovery و نامعلومبودن پایان رخداد.
چکلیست مانیتورینگ تیم کوچک
- مسیرهای حیاتی کاربر و Health Check مشخصاند.
- دسترسپذیری، زمان پاسخ و نرخ خطا پایش میشوند.
- CPU، RAM، Disk و اتصالهای دیتابیس دیده میشوند.
- Logها زمان، سطح، سرویس و شناسه درخواست دارند.
- اطلاعات حساس از Telemetry حذف شده است.
- هشدارها مالک، شدت و Runbook دارند.
- Retention و مصرف Disk تعریف و مانیتور شده است.
- پس از رخداد، علت و اقدام اصلاحی ثبت میشود.
سؤالات متداول مانیتورینگ سرویس
برای شروع Uptime Kuma کافی است؟
برای فهمیدن اینکه سرویس دردسترس است نقطه شروع خوبی است، اما علت کندی یا خطا را کامل نشان نمیدهد. با رشد محصول، متریک و Log را هم اضافه کنید.
Grafana داده را کجا نگه میدارد؟
Grafana معمولاً داده مانیتورینگ را از Data Source میخواند و نمایش میدهد. منبع متریک، Log یا Trace باید جداگانه انتخاب و پیکربندی شود.
هر Log را چقدر نگه داریم؟
عدد ثابت برای همه پروژهها وجود ندارد. نیاز عیبیابی، الزامات قانونی، حجم تولید و هزینه ذخیرهسازی را بسنجید و برای هر نوع Log سیاست Retention مشخص بگذارید.
چه زمانی Trace لازم میشود؟
وقتی یک درخواست از چند سرویس عبور میکند و با Metric و Log نمیتوانید محل کندی یا شکست را پیدا کنید، Trace ارزش زیادی دارد.
چطور هشدارهای بیفایده را کم کنیم؟
شرط را به اثر کاربر نزدیک کنید، بازه زمانی و Retry بگذارید، رخدادهای مشابه را گروهبندی کنید و هشدارهایی را که اقدام مشخصی ندارند حذف یا بازطراحی کنید.
منابع رسمی
- راهنمای رسمی مفاهیم Observability در OpenTelemetry
- مستند رسمی Data Sourceها در Grafana
- مستند رسمی داشبوردهای Grafana
- مستند رسمی Status Page در Uptime Kuma
- مستند رسمی مانیتورینگ Log در Elastic
گام بعدی: از یک سرویس و سه شاخص شروع کنید. Uptime Kuma را برای دسترسپذیری بسازید، متریکهای اصلی را در Grafana ببینید و Logهای مهم را در ELK متمرکز کنید. بعد از یک هفته، هشدارهای بیاقدام را حذف و داشبورد را براساس رخدادهای واقعی اصلاح کنید.
سوالات متداول
برای شروع Uptime Kuma کافی است؟
برای فهمیدن اینکه سرویس دردسترس است نقطه شروع خوبی است، اما علت کندی یا خطا را کامل نشان نمیدهد. با رشد محصول، متریک و Log را هم اضافه کنید.
Grafana داده را کجا نگه میدارد؟
Grafana معمولاً داده مانیتورینگ را از Data Source میخواند و نمایش میدهد. منبع متریک، Log یا Trace باید جداگانه انتخاب و پیکربندی شود.
هر Log را چقدر نگه داریم؟
عدد ثابت برای همه پروژهها وجود ندارد. نیاز عیبیابی، الزامات قانونی، حجم تولید و هزینه ذخیرهسازی را بسنجید و برای هر نوع Log سیاست Retention مشخص بگذارید.
چه زمانی Trace لازم میشود؟
وقتی یک درخواست از چند سرویس عبور میکند و با Metric و Log نمیتوانید محل کندی یا شکست را پیدا کنید، Trace ارزش زیادی دارد.
چطور هشدارهای بیفایده را کم کنیم؟
شرط را به اثر کاربر نزدیک کنید، بازه زمانی و Retry بگذارید، رخدادهای مشابه را گروهبندی کنید و هشدارهایی را که اقدام مشخصی ندارند حذف یا بازطراحی کنید.



نظرات کاربران