

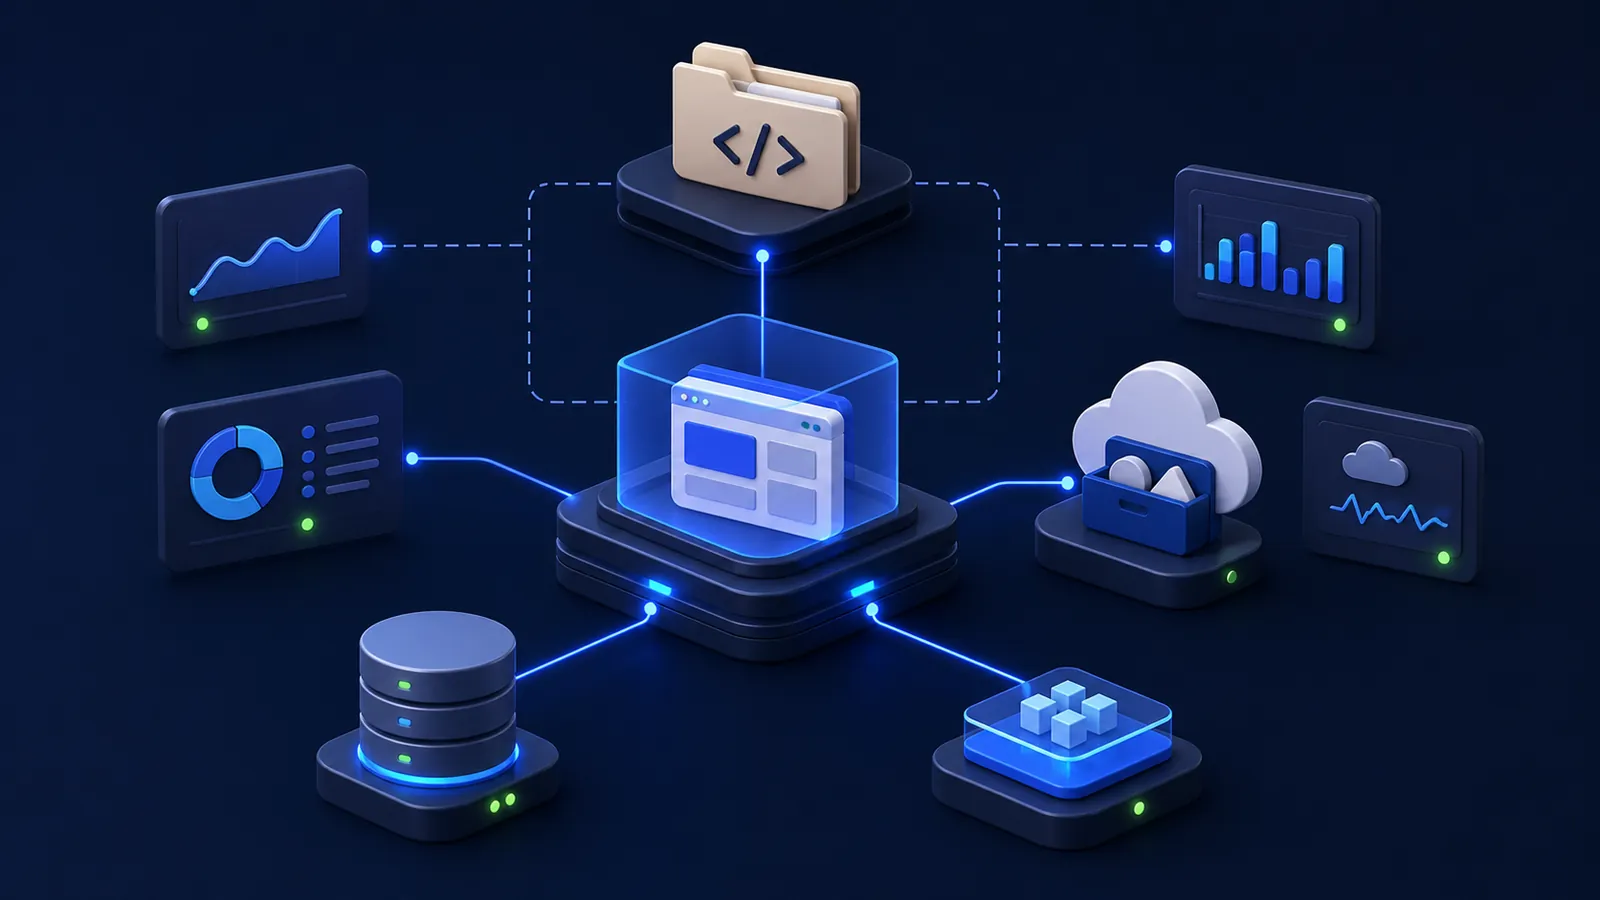
پاسخ سریع: اگر با ابزارهای هوش مصنوعی یک اپلیکیشن میسازید، خروجی کد بهتنهایی برای انتشار کافی نیست. حداقل به مخزن کد و تاریخچه تغییرات، محیط اجرای برنامه، پایگاه داده، مدیریت فایل و رمزها، دامنه و HTTPS، نسخه پشتیبان و یک روش پایش خطا و دسترسپذیری نیاز دارید. همه پروژهها به همه ابزارها از روز اول احتیاج ندارند؛ معماری باید از مسئله و نوع داده شروع شود.
ساخت یک صفحه یا API با کمک هوش مصنوعی میتواند چند ساعت طول بکشد، اما تبدیل همان نمونه به سرویسی که کاربران واقعی به آن اعتماد کنند مرحله دیگری است. در این مرحله باید پاسخ دهید کد کجا نگهداری میشود، برنامه کجا اجرا میشود، دادهها کجا میمانند، چه کسی به رمزها دسترسی دارد و اگر سرویس از کار افتاد چگونه متوجه میشوید.
این راهنما برای کاربر تازهکاری نوشته شده که شاید توسعهدهنده زیرساخت نباشد، اما میخواهد مسیر میان «نمونه ساختهشده با AI» و «محصول قابل استفاده» را بفهمد.
چرا کد تولیدشده با AI هنوز یک محصول کامل نیست؟
ابزار هوش مصنوعی میتواند فایلهای پروژه، رابط کاربری، Query و حتی پیکربندی استقرار را پیشنهاد دهد. بااینحال، مدل از وضعیت واقعی زیرساخت شما، دسترسی کاربران، محدودیتهای شبکه و دادههای محرمانه اطلاع کامل ندارد. ممکن است کد اجرا شود اما در برابر قطع ارتباط، ورودی نامعتبر، رشد داده یا تغییر همزمان چند نفر آماده نباشد.
محصول نرمافزاری فقط مجموعهای از فایلها نیست. محصول یک سیستم است: کد، داده، محیط اجرا، دسترسی، مشاهدهپذیری، پشتیبانگیری و فرایند انتشار باید با هم کار کنند.
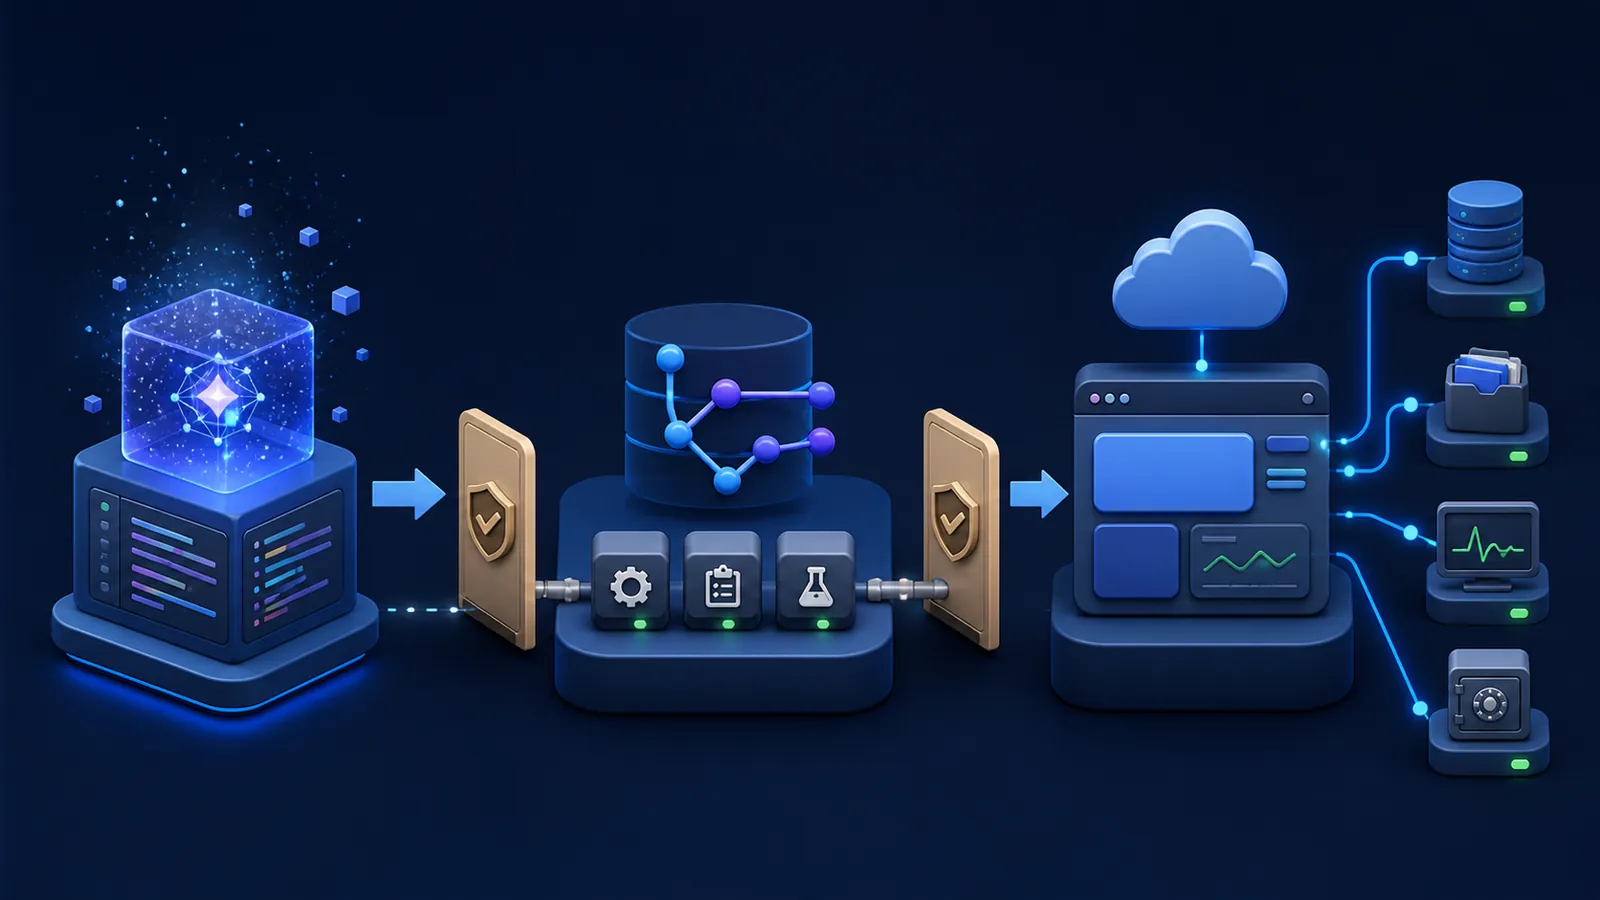
نقشه ساده زیرساخت یک اپلیکیشن
برای شروع، معماری را به هشت قطعه تقسیم کنید. بعضی قطعهها میتوانند در یک سرویس جمع شوند و بعضی باید مستقل باشند.
- مخزن کد و کنترل نسخه برای نگهداری تاریخچه و بازگشت به نسخه سالم؛
- محیط Build و Deploy برای تبدیل کد به نسخه قابل اجرا؛
- Runtime یا محیط اجرای برنامه مانند Node.js یا Container؛
- پایگاه داده برای اطلاعات ساختاریافته و پایدار؛
- Cache یا صف برای سرعت و پردازش غیرهمزمان، فقط در صورت نیاز؛
- فضای فایل و Object Storage برای تصویر، ویدئو، خروجی و Backup؛
- امنیت و مدیریت Secret برای رمزها، Tokenها و کلیدها؛
- Monitoring، Log و Backup برای دیدن سلامت سیستم و بازیابی.
۱. مخزن کد؛ اولین حفاظ پروژه
مخزن (Repository) محلی است که فایلهای پروژه و تاریخچه تغییرات در آن نگهداری میشوند. حتی اگر یک نفر روی پروژه کار میکند، کنترل نسخه به او اجازه میدهد بفهمد چه چیزی تغییر کرده و در صورت خطا به نسخه قبلی برگردد.
در GitLab، پروژه فقط مخزن نیست؛ امکانات همکاری، Issue، Merge Request و CI/CD نیز کنار کد قرار میگیرند. مستندات رسمی GitLab توضیح میدهند که یک Project میتواند مخزن، ابزارهای همکاری، مدیریت کار و قابلیتهای Build، Test و Deploy را یکجا نگه دارد.
برای کد تولیدشده با AI، Branch جدا و Merge Request اهمیت بیشتری پیدا میکند. تغییر بزرگ را مستقیم وارد شاخه اصلی نکنید. آن را در شاخه جدا ثبت کنید، تفاوت فایلها را بخوانید و آزمونها را اجرا کنید. برای جزئیات، (چرا پروژههای AI به GitLab نیاز دارند؟) و (کنترل کد تولیدشده با AI) را بخوانید.
حداقل قانونهای مخزن
- فایل
.envو کلیدهای دسترسی را Commit نکنید. - برای هر تغییر مهم یک Commit با توضیح روشن بسازید.
- شاخه اصلی را برای انتشارهای بررسیشده نگه دارید.
- پیش از Merge، تست و بازبینی انسانی انجام دهید.
- برای تغییر دیتابیس، Migration قابل برگشت در نظر بگیرید.
۲. محیط اجرا و استقرار؛ کد کجا زنده میشود؟
Runtime محیطی است که برنامه در آن اجرا میشود. برای یک پروژه JavaScript ممکن است Node.js باشد؛ برای پروژه Containerized، Image و Container نقش اصلی دارند. محیط توسعه روی لپتاپ با محیط عملیاتی یکسان نیست: نسخه Runtime، متغیرهای محیطی، پورت، دامنه و منابع باید مشخص باشند.
اگر پروژه شما Node.js است، (راهنمای دیپلوی Node.js در آرانیک) مسیر اجرای API و برنامه را پوشش میدهد. اگر چند پروژه، اتصال Git و Deploy خودکار میخواهید، (راهنمای Coolify) را بررسی کنید.
چه چیزهایی باید در Deploy مشخص شوند؟
- فرمان Build و فرمان Start؛
- نسخه Runtime؛
- Port داخلی برنامه؛
- متغیرهای محیطی و Secretها؛
- Health Check؛
- دامنه و HTTPS؛
- روش بازگشت به نسخه قبلی.
اگر AI برای شما فایل Dockerfile یا تنظیمات Deploy ساخته است، آن را بدون بررسی اجرا نکنید. Image پایه، دسترسی Root، پورتهای باز و قرارگرفتن Secret در لایههای Image را کنترل کنید.
۳. پایگاه داده؛ حافظه پایدار محصول
پایگاه داده برای نگهداری اطلاعاتی است که پس از توقف یا بهروزرسانی برنامه نباید از بین بروند: حساب کاربران، سفارشها، وضعیت کارها و تنظیمات. PostgreSQL در معماری کارخواه/کارساز (Client/Server) اجرا میشود؛ برنامه به سرور دیتابیس متصل میشود و عملیات داده را از طریق همان اتصال انجام میدهد.
برای دادههای تراکنشی و دارای رابطه، PostgreSQL، MySQL یا MariaDB معمولاً نقطه شروع قابل فهمی هستند. اگر ساختار داده شما سندمحور و متغیر است، MongoDB ممکن است مناسب باشد. انتخاب را بر اساس مدل داده و Query انجام دهید، نه بر اساس پیشنهاد تصادفی ابزار AI.
برای مقایسه و اتصال اولیه، (راهنمای PostgreSQL، MySQL و MariaDB) و (راهنمای MongoDB، Redis و RabbitMQ) را ببینید.
قانونهای پایه دیتابیس
- اطلاعات اتصال را در کد ننویسید؛ از متغیر محیطی استفاده کنید.
- برای برنامه، کاربر دیتابیس با حداقل دسترسی لازم بسازید.
- Migrationها را همراه کد نسخهبندی کنید.
- قبل از تغییر Schema از داده مهم Backup بگیرید.
- بازیابی را آزمایش کنید؛ وجود فایل Backup کافی نیست.
۴. Redis و RabbitMQ؛ فقط وقتی مسئله واقعی دارید
هر پروژه از روز اول به Cache و صف نیاز ندارد. اضافهکردن سرویس بدون نیاز مشخص، هزینه و سطح خطا را بیشتر میکند.
Redis مجموعهای از ساختارهای داده را ارائه میدهد و میتواند برای Cache، شمارنده، Session و بعضی الگوهای صف استفاده شود. RabbitMQ برای پیام و پردازش غیرهمزمان مناسب است؛ برای مثال وقتی تولید گزارش نباید درخواست کاربر را چند دقیقه منتظر نگه دارد.
Redis را زمانی اضافه کنید که اندازهگیری نشان دهد داده پرتکرار یا Session به مسیر سریعتری نیاز دارد. صف را زمانی اضافه کنید که یک کار طولانی، قابل تکرار یا نیازمند Retry باید از درخواست اصلی جدا شود.
۵. فایلها را کجا نگه داریم؟
ذخیره فایل بارگذاریشده داخل پوشه برنامه در نمونه اولیه ساده است، اما در زمان Deploy مجدد، جابهجایی سرویس یا اجرای چند Instance مشکل ایجاد میکند. Object Storage فضای جداگانهای برای فایلهایی مانند تصویر، ویدئو، سند، خروجی و نسخه پشتیبان فراهم میکند.
اگر برنامه با رابط سازگار با S3 کار میکند، MinIO میتواند گزینهای برای ساخت Object Storage روی زیرساخت انتخابی باشد. مسیر راهاندازی در (راهنمای MinIO و ذخیرهسازی سازگار با S3) آمده است.
سه نکته برای فایل
- نوع و اندازه فایل ورودی را اعتبارسنجی کنید.
- فایل خصوصی را با URL عمومی دائمی منتشر نکنید.
- چرخه نگهداری، حذف و Backup فایلها را مشخص کنید.
۶. Secret، دامنه و HTTPS
Secret اطلاعاتی مانند رمز دیتابیس، Token سرویس، کلید امضای Session و کلید API است. این مقادیر نباید در Prompt عمومی، کد، Commit یا Screenshot قرار بگیرند. آنها را از طریق متغیر محیطی یا ابزار مدیریت Secret به Runtime بدهید و برای محیط توسعه و Production مقدار جدا داشته باشید.
دامنه آدرس قابل فهم سرویس است و HTTPS ارتباط مرورگر تا برنامه را رمزگذاری میکند. فعالبودن HTTPS بهتنهایی همه مشکلات امنیتی را حل نمیکند، اما برای ورود، Cookie و ارسال داده ضروری است.
برای پروژهای که AI ساخته است، مسیرهای ورود، بازیابی رمز، سطح دسترسی و اعتبارسنجی ورودی را جداگانه آزمایش کنید. ظاهر درست صفحه نشانه امنبودن منطق پشت آن نیست.
۷. Monitoring و Log؛ قبل از کاربر متوجه خطا شوید
پایش (Monitoring) به شما میگوید سیستم در چه وضعیتی است؛ لاگ (Log) جزئیات رویدادها و خطاها را ثبت میکند. این دو جای هم را نمیگیرند. ممکن است Uptime Kuma نشان دهد صفحه پاسخ نمیدهد، Grafana افزایش مصرف CPU را نشان دهد و ELK Stack خطای دقیق برنامه را پیدا کند.
- برای بررسی در دسترسبودن URL: (Uptime Kuma).
- برای نمودار متریکها و منابع: (Grafana).
- برای جمعآوری و جستوجوی لاگ: (ELK Stack).
در MVP لازم نیست از روز اول یک پشته بزرگ Observability بسازید. یک Health Check، هشدار قطعی، ثبت خطای ساختاریافته و کنترل CPU، RAM و Disk شروع مناسبی است.
۸. Backup و برنامه بازیابی
Backup یک قابلیت جانبی نیست؛ بخشی از طراحی محصول است. مشخص کنید از چه چیزهایی نسخه میگیرید: دیتابیس، فایلهای کاربر، تنظیمات سرویس و کلیدهای لازم برای بازیابی. سپس هدف زمان بازیابی و مقدار داده قابل از دست رفتن را بر اساس اهمیت محصول تعیین کنید.
نسخه پشتیبان را در همان دیسکی که سرویس روی آن اجرا میشود تنها نگذارید. یک خرابی میتواند هر دو را از بین ببرد. مهمتر از تهیه Backup، آزمایش Restore در یک محیط جداست.
سه معماری پیشنهادی برای شروع
نمونه نمایشی یا Proof of Concept
- مخزن Git؛
- یک محیط اجرای ساده؛
- دیتابیس فقط در صورت نیاز؛
- داده غیرحساس و قابل حذف؛
- بدون کاربر واقعی یا پرداخت.
هدف این مرحله آزمودن مسئله است، نه ساخت معماری نهایی. بااینحال کد را از همان ابتدا در Repository نگه دارید.
MVP با کاربر واقعی
- GitLab و فرایند بازبینی؛
- محیط Deploy تکرارپذیر؛
- دیتابیس مستقل با Backup؛
- دامنه و HTTPS؛
- Secret خارج از کد؛
- هشدار قطعی و ثبت خطا؛
- قانون دسترسی کاربران.
محصول در حال رشد
- Pipeline آزمون و انتشار؛
- محیط Staging جدا؛
- پایش متریک و لاگ متمرکز؛
- Object Storage برای فایلها؛
- Cache یا Queue بر اساس گلوگاه اندازهگیریشده؛
- Backup دورهای با آزمایش Restore؛
- برنامه ظرفیت و ارتقای منابع.
چکلیست قبل از انتشار اپلیکیشن ساختهشده با AI
- کد در مخزن است و فایل حساس Commit نشده است.
- تغییرات اصلی توسط انسان خوانده شدهاند.
- تستهای اصلی روی ورود، مجوزها و جریان داده اجرا شدهاند.
- نسخه Runtime و فرمان Build مشخص است.
- متغیرهای محیطی توسعه و Production جدا هستند.
- دیتابیس کاربر محدود دارد و Migrationها ثبت شدهاند.
- دامنه و HTTPS درست کار میکنند.
- فایلها خارج از دیسک موقت برنامه نگهداری میشوند.
- هشدار قطعی و روش مشاهده خطا وجود دارد.
- Backup گرفته و حداقل یک بار Restore آزمایش شده است.
- روش بازگشت به نسخه قبلی معلوم است.
چطور سرویسها را در آرانیک بچینیم؟
ابتدا فقط اجزای ضروری را بسازید. برای نمونه، یک اپلیکیشن Node.js با داده تراکنشی میتواند با این ترتیب آغاز شود:
- GitLab برای مخزن و کنترل تغییرات؛
- Node.js یا Coolify برای اجرای برنامه؛
- PostgreSQL برای داده اصلی؛
- Uptime Kuma برای هشدار دسترسپذیری؛
- Object Storage، Redis، Queue و پشته لاگ فقط وقتی نیازشان ثابت شد.
برای ساخت هر جزء میتوانید از برنامههای آماده استفاده کنید. (ایزیاینستال آرانیک چیست؟) مسیر انتخاب سرویس، منابع و کارهای پس از نصب را توضیح میدهد.
پرسشهای متداول
برای یک اپلیکیشن ساختهشده با AI حداقل چه سرویسهایی لازم است؟
حداقل مخزن کد، محیط اجرا و روشی برای نگهداری Secret لازم است. اگر داده پایدار دارید، دیتابیس و Backup هم ضروریاند. برای کاربر واقعی، دامنه، HTTPS و هشدار قطعی را اضافه کنید.
آیا میتوان کد AI را مستقیم روی سرور منتشر کرد؟
از نظر فنی ممکن است، اما برای محیط واقعی کار امنی نیست. ابتدا کد را در Branch جدا ثبت کنید، تفاوتها را بخوانید، تست کنید و روش بازگشت به نسخه قبلی داشته باشید.
آیا هر پروژه به Redis و RabbitMQ نیاز دارد؟
خیر. Redis زمانی مفید است که نیاز مشخصی مانند Cache یا Session دارید. RabbitMQ زمانی ارزش دارد که کارهای غیرهمزمان و نیازمند Retry دارید. بدون مسئله واقعی، پیچیدگی اضافه میکنند.
برای داده اصلی PostgreSQL بهتر است یا MongoDB؟
پاسخ به مدل داده و Query بستگی دارد. اگر رابطه، تراکنش و ساختار مشخص دارید، دیتابیس رابطهای نقطه شروع خوبی است. برای سندهای متغیر و الگوهای خاص، MongoDB ممکن است مناسب باشد. انتخاب را با نمونه Query و نیاز واقعی آزمایش کنید.
اول Monitoring راهاندازی کنم یا Backup؟
هر دو مسئله متفاوتی حل میکنند. Monitoring وقوع مشکل را نشان میدهد؛ Backup امکان بازیابی داده را میدهد. برای MVP واقعی، حداقل هشدار قطعی و Backup قابل بازیابی را همزمان در نظر بگیرید.
آیا ایزیاینستال همه مسئولیت زیرساخت را حذف میکند؟
خیر. نصب اولیه را ساده میکند، اما معماری، سطح دسترسی، داده، Backup، نسخه برنامه و نگهداری داخل سرویس همچنان باید مدیریت شوند.
منابع رسمی
- مستند رسمی GitLab درباره Project، Repository و CI/CD.
- مستند رسمی GitLab Repository.
- مستند رسمی PostgreSQL درباره معماری Client/Server.
- مستند رسمی Redis درباره ساختارهای داده و کاربردها.
- صفحه رسمی خدمات ابری و برنامههای آماده آرانیک.
قدم بعدی: معماری پروژه را روی یک صفحه با چهار جعبه «کد، اجرا، داده و پایش» بنویسید. سپس وارد داشبورد آرانیک شوید و فقط سرویسهای ضروری نسخه اول را بسازید. هر نیاز جدید را بعد از اندازهگیری به معماری اضافه کنید.
سوالات متداول
برای یک اپلیکیشن ساختهشده با AI حداقل چه سرویسهایی لازم است؟
حداقل مخزن کد، محیط اجرا و روشی برای نگهداری Secret لازم است. اگر داده پایدار دارید، دیتابیس و Backup هم ضروریاند.
آیا میتوان کد AI را مستقیم روی سرور منتشر کرد؟
از نظر فنی ممکن است، اما برای محیط واقعی امن نیست. ابتدا کد را در Branch جدا ثبت کنید، تفاوتها را بخوانید، تست کنید و روش بازگشت داشته باشید.
آیا هر پروژه به Redis و RabbitMQ نیاز دارد؟
خیر. Redis زمانی مفید است که نیاز مشخصی مانند Cache یا Session دارید. RabbitMQ زمانی ارزش دارد که کارهای غیرهمزمان و نیازمند Retry دارید.
اول Monitoring راهاندازی کنم یا Backup؟
هر دو مسئله متفاوتی حل میکنند. Monitoring وقوع مشکل را نشان میدهد؛ Backup امکان بازیابی داده را میدهد. برای MVP واقعی هر دو را حداقلی در نظر بگیرید.
آیا ایزیاینستال همه مسئولیت زیرساخت را حذف میکند؟
خیر. نصب اولیه را ساده میکند، اما معماری، سطح دسترسی، داده، Backup، نسخه برنامه و نگهداری داخل سرویس همچنان باید مدیریت شوند.



نظرات کاربران